FrameTrain Screenshots: so sieht lokales ML-Training aus
Keine Mockups und kein Video, das nach zwei Minuten wieder von vorn läuft. Die folgenden Screenshots zeigen die Desktop-App so, wie sie auf dem Rechner läuft – in der Reihenfolge, in der man ihr begegnet: zuerst die Startseite, auf der man nach dem Login landet, dann der Import eines HuggingFace-Modells, die Trainingskonfiguration und am Ende Loss-Kurven und Modellversionen. Jeder Abschnitt erklärt, was das Panel tut und an welcher Stelle des Ablaufs es sitzt.
Alle Screenshots stammen aus der deutschen Oberfläche. Die App ist vollständig zweisprachig – über die Sprachumschaltung siehst du dieselben Panels auf Englisch.
01
Startseite – was passiert ist, während du weg warst
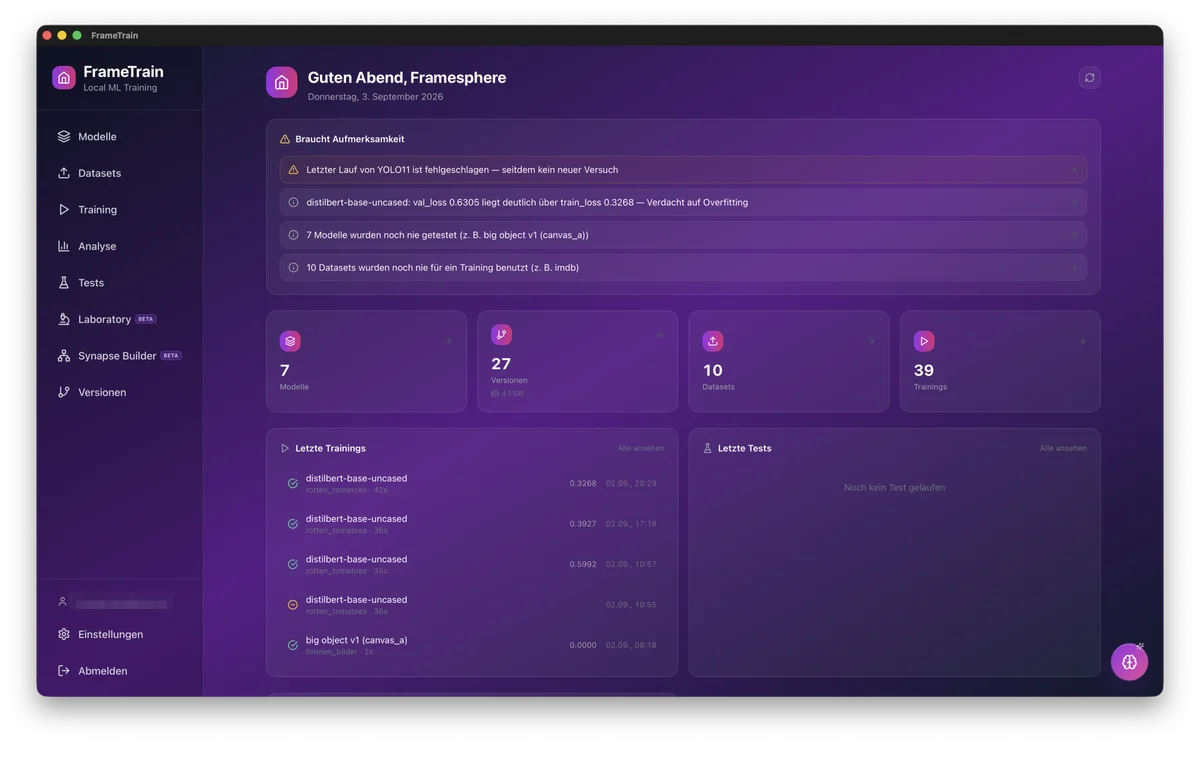
Nach dem Login öffnet FrameTrain nicht mehr mitten in der Modell-Liste, sondern auf einer Übersicht des Projektstands: Läuft gerade ein Training, samt Fortschritt? Was ist seit dem letzten Besuch fertig geworden oder fehlgeschlagen? Darunter Kennzahlen inklusive Speicherbelegung, die letzten Trainings und Tests, der Loss-Trend der letzten Läufe und eine Bestenliste nach Accuracy. Jede Kachel ist ein Sprung in den passenden Bereich – die Startseite ist ein Statusbericht, kein zweites Menü. Über den Home-Button oben links in der Seitenleiste kommst du jederzeit zurück.
Die Startseite: oben die Hinweise, die gerade Aufmerksamkeit brauchen, darunter Kennzahlen und die letzten Läufe – jede Karte führt direkt in den zugehörigen Bereich.
Laufende Trainings mit Fortschritt und Ergebnisse seit dem letzten Besuch
„Braucht Aufmerksamkeit“ warnt regelbasiert – ohne KI und ohne Kosten
KI-Briefing auf Knopfdruck, gespeichert und nur bei echter Änderung neu
02
Modelle verwalten – HuggingFace und Lokales an einem Ort
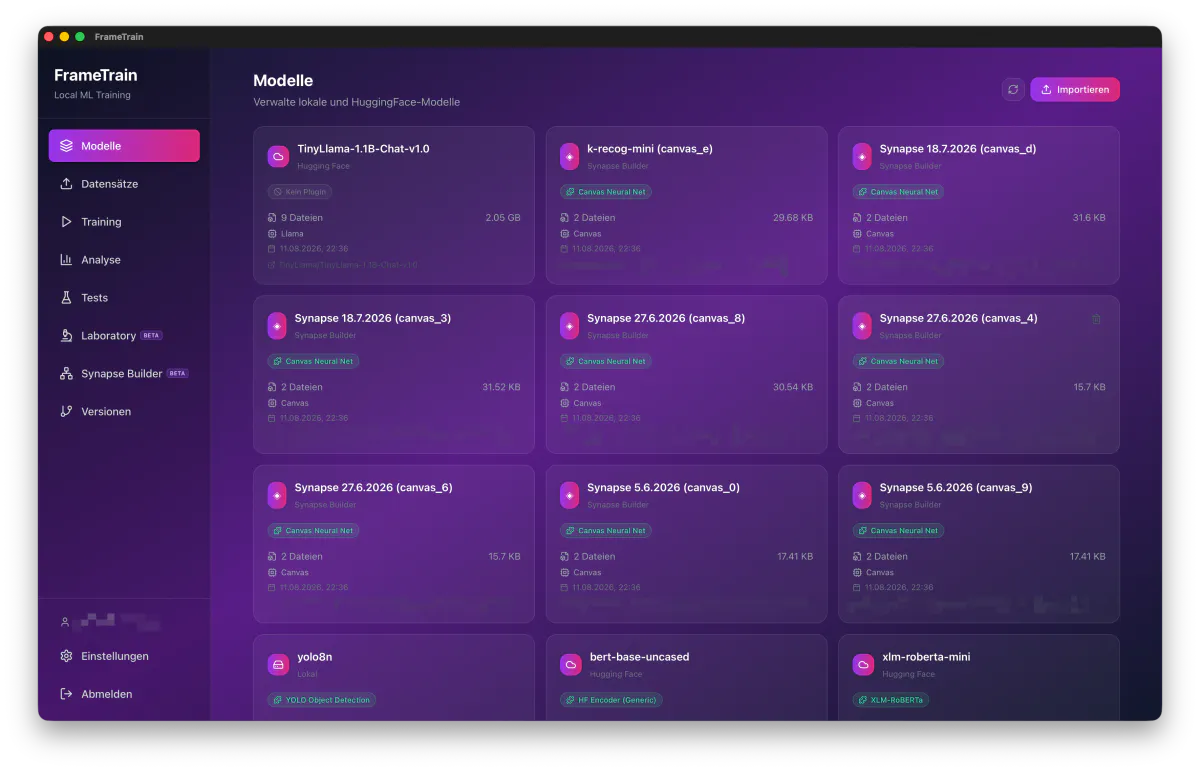
Die Modellübersicht listet alles, was FrameTrain kennt: von HuggingFace importierte Modelle, lokal abgelegte Gewichte und im Synapse Builder selbst gebaute Netze. Jede Karte zeigt Dateianzahl, Größe auf der Platte, Ablagepfad und das Plugin, das für dieses Modell zuständig ist. Modelle ohne passendes Plugin sind vorab als solche markiert, statt erst beim Trainingsstart zu scheitern.
Modellübersicht: TinyLlama, xlm-roberta, YOLO und eigene Canvas-Netze nebeneinander, mit Größe, Datum und zuständigem Plugin.
Import von HuggingFace über die Repo-ID
Größe, Dateianzahl und Speicherpfad pro Modell
Plugin-Erkennung für XLM-RoBERTa, YOLO, Llama und weitere
03
Datensätze – Parquet, Flat Files und Splits
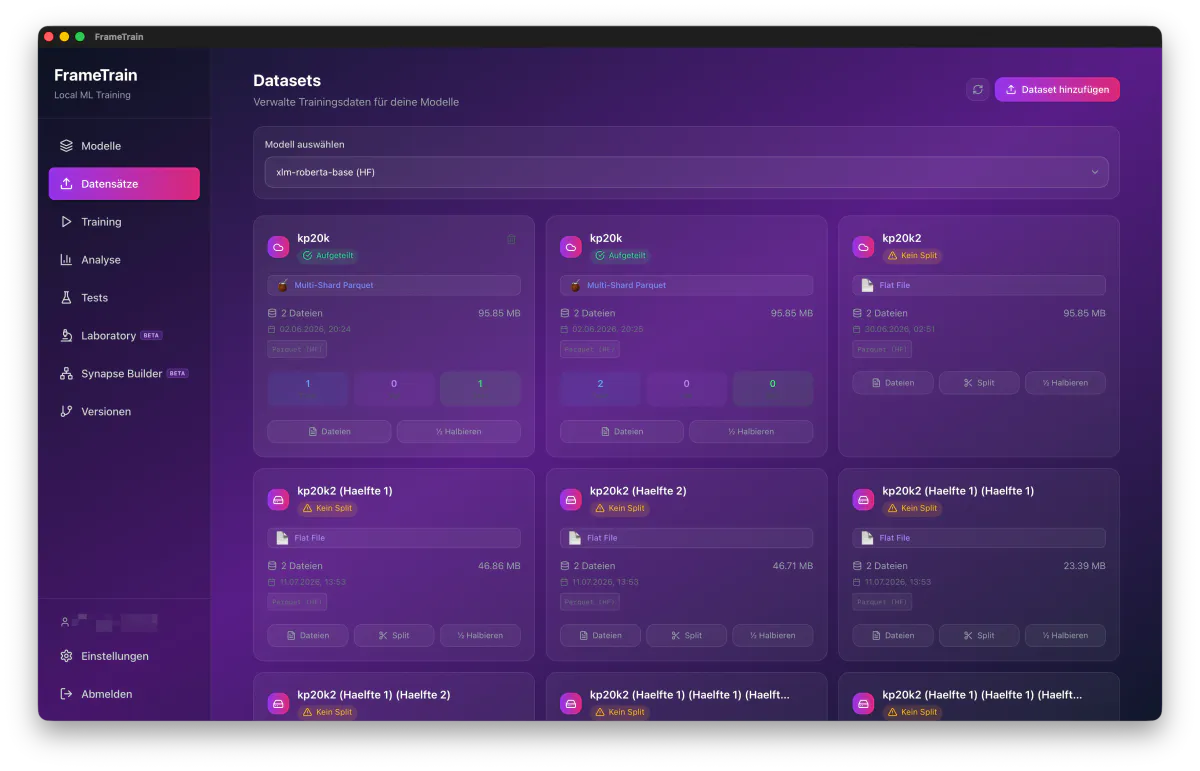
Datensätze hängen am Modell: Die Auswahl oben filtert die Liste auf das, was zum gewählten Modell passt. FrameTrain liest Multi-Shard-Parquet nativ, zeigt Dateigröße und Änderungsdatum und markiert, ob bereits ein Train-/Val-/Test-Split existiert. Fehlt einer, teilst du den Datensatz direkt in der App – halbieren inklusive.
Datensätze pro Modell, mit Format, Größe und Split-Status. „Kein Split“ ist ein Hinweis, kein Fehler – teilen geht direkt hier.
Multi-Shard-Parquet wird nativ unterstützt
Train-/Val-/Test-Split ohne Umweg über die Kommandozeile
Kompatibilitätsprüfung gegen das gewählte Modell
04
Datensatz-Werkstatt – eigene Datensätze beschriften
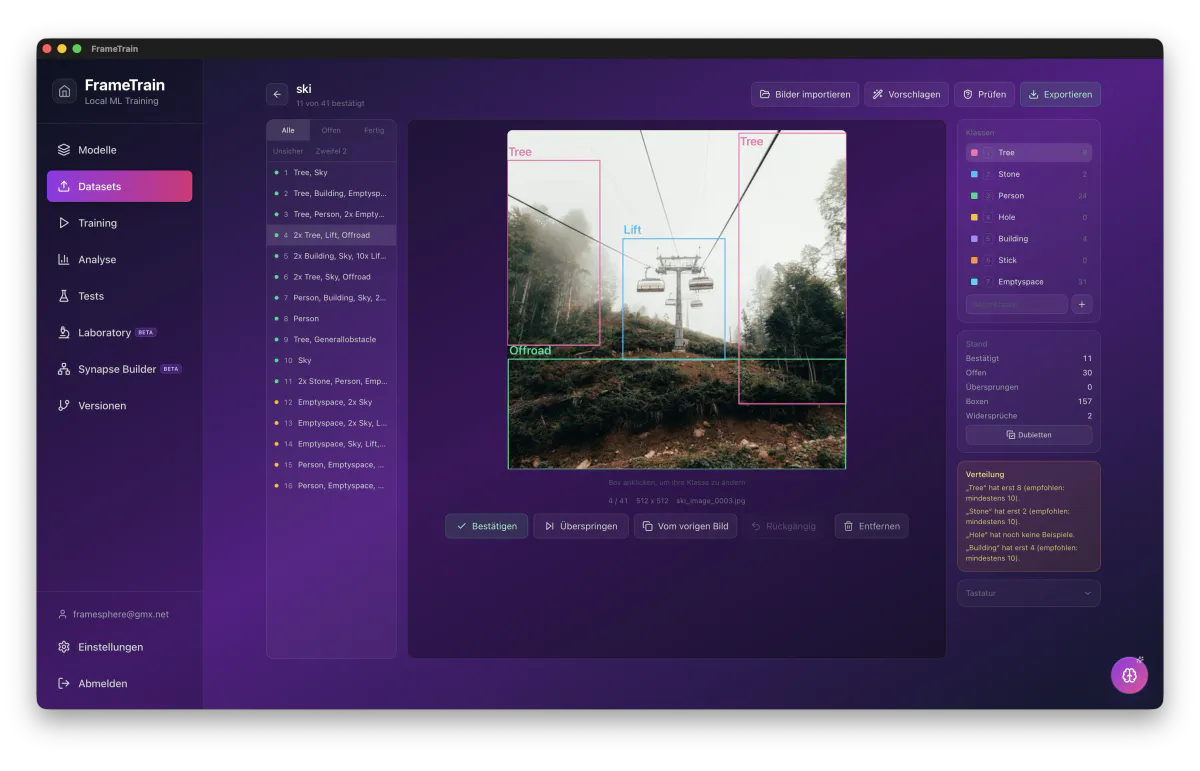
Seit Version 1.3.4 baust du Datensätze direkt in FrameTrain. Die Bild-Werkbank zeigt das Prinzip: Boxen aufziehen, Klasse per Zifferntaste wählen, mit Enter bestätigen. Ein trainiertes Modell kann Vorschläge machen, der Filter „Unsicher“ bringt die schwierigsten Fälle nach vorn, und rechts siehst du, welche Klassen noch zu wenige Beispiele haben. Neben Bildern gibt es Projektarten für Texte, Aufnahmen, Transkripte und Videoabschnitte.
Beschriften per Tastatur, mit Vorschlägen und Warnungen zur Klassenverteilung.
Sieben Projektarten für Bild, Text, Audio und Video
Modellvorschläge, die unsichersten zuerst
Export direkt im Format des passenden Trainings-Plugins
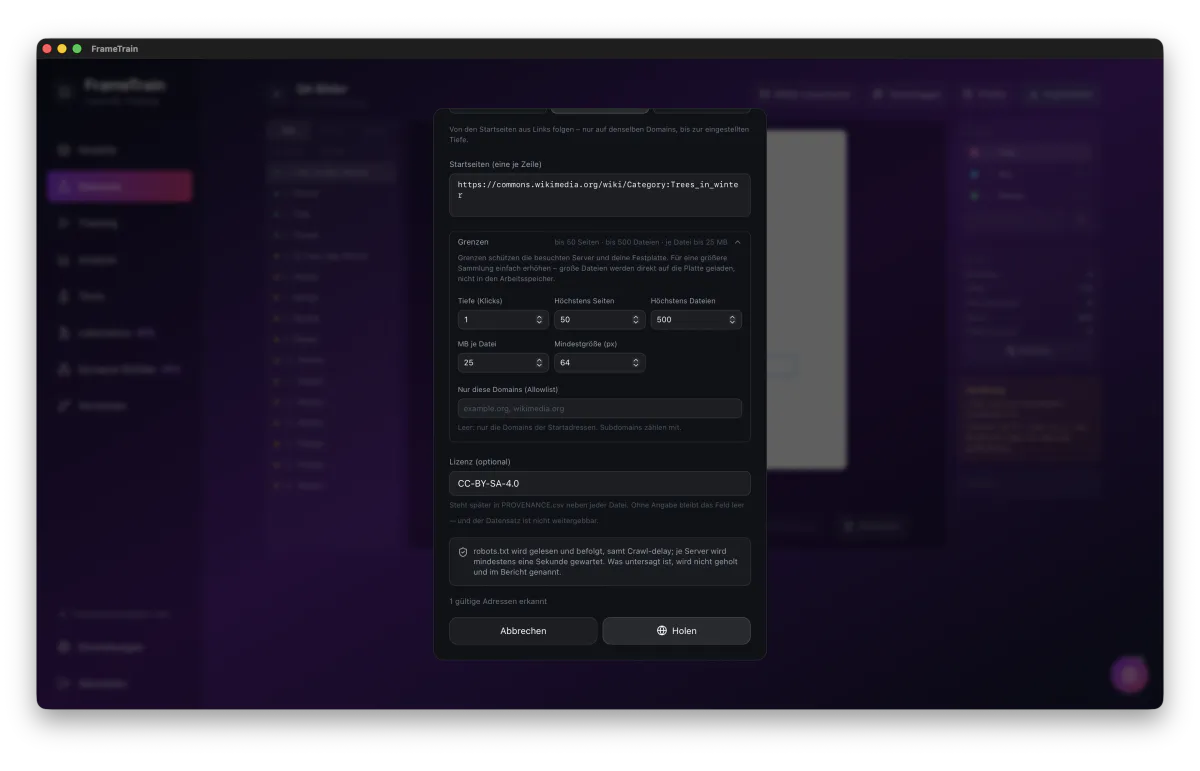
Statt Dateien einzeln herunterzuladen, gibst du der Werkstatt Adressen, ganze Websites oder eine Sitemap. FrameTrain folgt Links nur bis zur gewählten Tiefe und nur auf denselben Domains, hält Grenzen für Seiten, Dateien und Dateigröße ein und befolgt robots.txt samt Crawl-delay. Jede geholte Datei bekommt Adresse, Fundseite und Lizenz in PROVENANCE.csv.
Website-Modus mit aufgeklappten Grenzen. robots.txt wird immer befolgt.
Training konfigurieren – Hyperparameter, LoRA und QLoRA
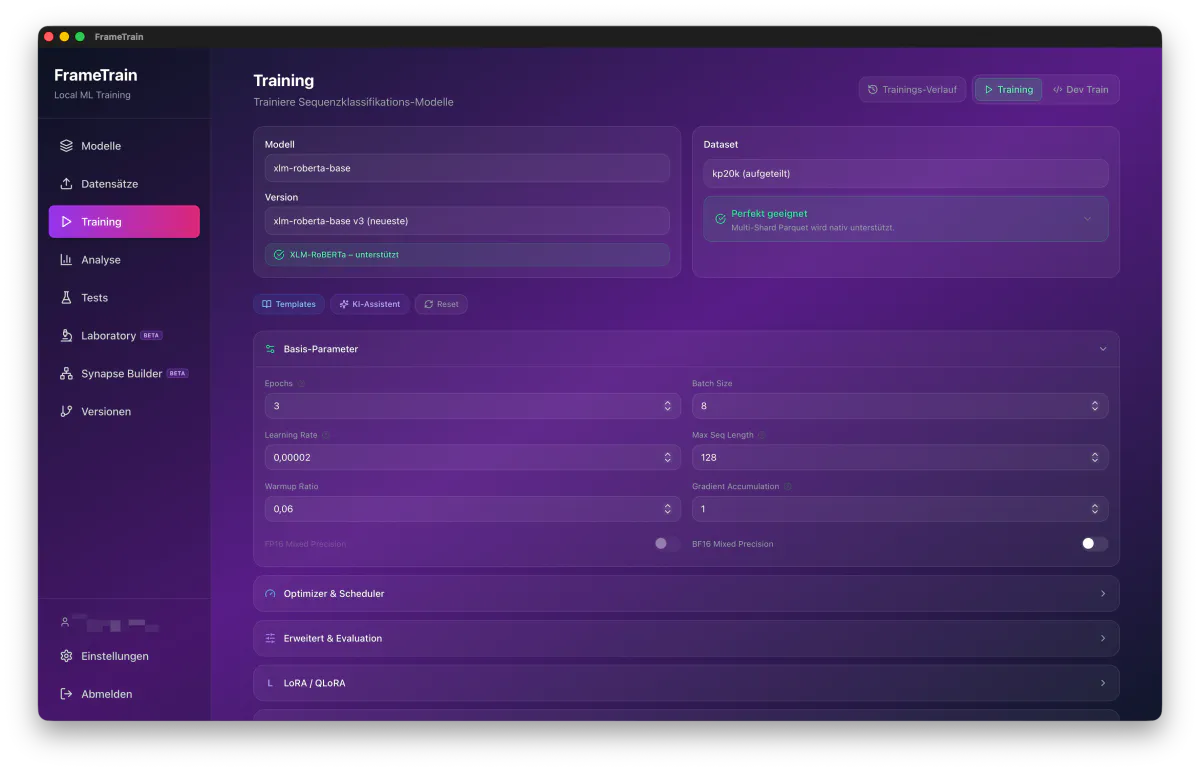
Der Trainingsbereich zeigt Modell, Version und Datensatz nebeneinander und prüft vorab, ob das Plugin diese Kombination unterstützt. Die Basis-Parameter stehen offen: Epochs, Batch Size, Learning Rate, Max Seq Length, Warmup Ratio und Gradient Accumulation. Optimizer & Scheduler, Erweitert & Evaluation sowie LoRA / QLoRA klappen bei Bedarf auf. Mixed Precision lässt sich pro Backend umschalten – FP16 bleibt gesperrt, wo die Hardware BF16 verlangt.
Trainingskonfiguration für xlm-roberta-base: Basis-Parameter offen, Optimizer, Evaluation und LoRA/QLoRA eine Ebene tiefer.
LoRA und QLoRA als eigener Konfigurationsabschnitt
Templates und KI-Assistent liefern belastbare Startwerte
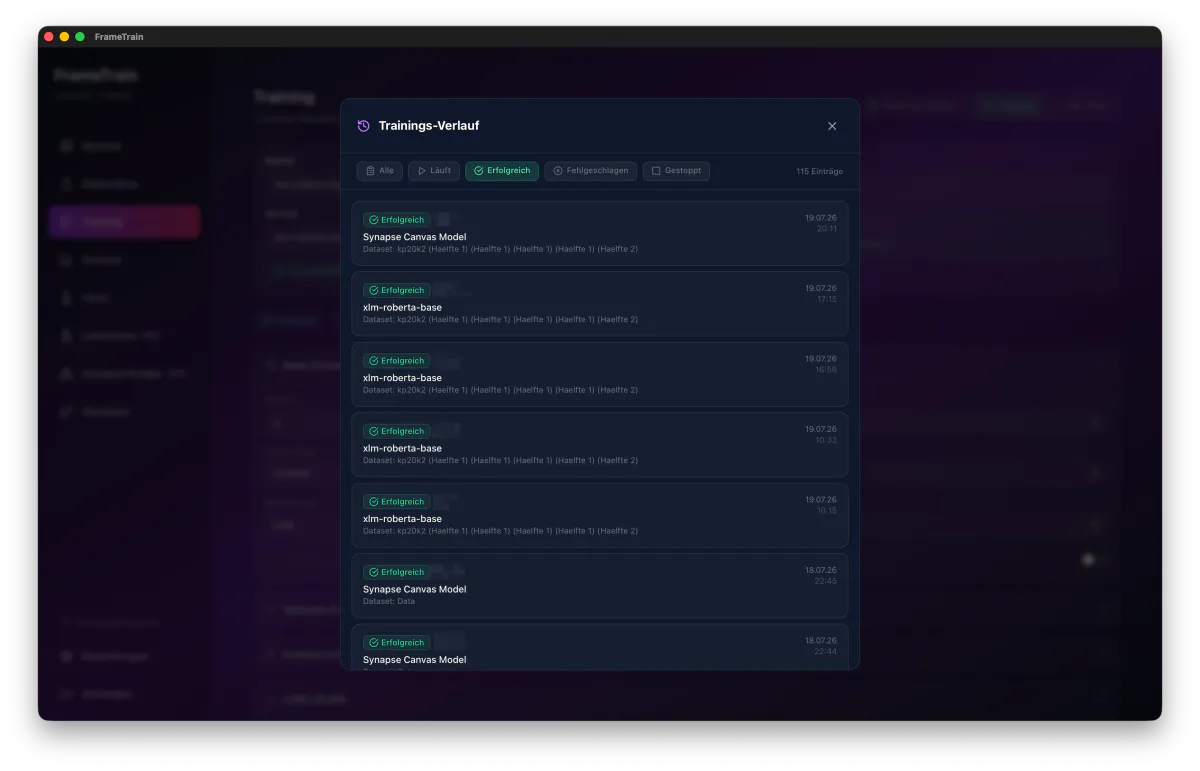
Der Verlauf sammelt jeden Lauf mit Status, Dauer, Modell und verwendetem Datensatz, filterbar nach Läuft, Erfolgreich, Fehlgeschlagen und Gestoppt. Damit bleibt auch Monate später nachvollziehbar, welcher Datensatz zu welchem Ergebnis geführt hat – die Frage, an der Experimente ohne Protokoll regelmäßig scheitern.
Trainings-Verlauf mit Statusfiltern. Der verwendete Datensatz steht an jedem Eintrag.
Filter nach Läuft, Erfolgreich, Fehlgeschlagen und Gestoppt
Datensatz und Modell je Lauf protokolliert
Zeitstempel und Laufzeit auf einen Blick
08
Loss-Kurven und Overfitting-Indikator
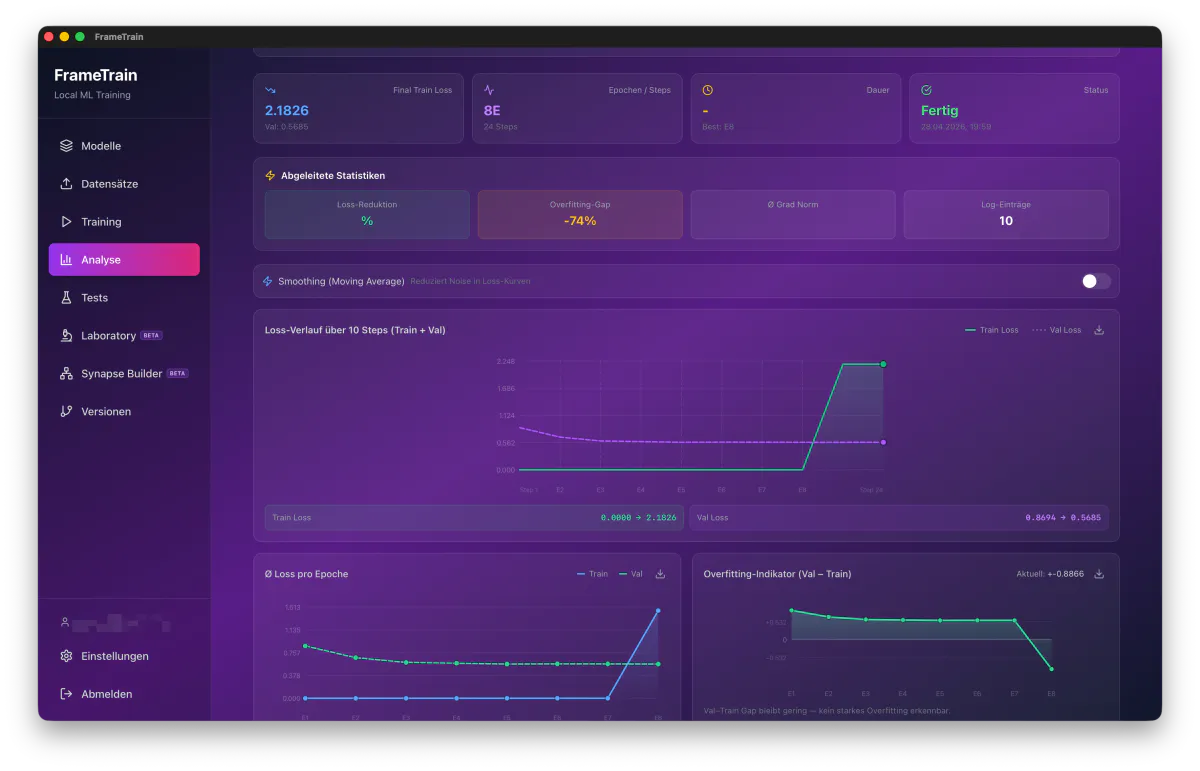
Loss-Verlauf, Ø Loss pro Epoche und ein Overfitting-Indikator (Val minus Train) liegen untereinander auf einer Seite. Ein Smoothing-Schalter nimmt Rauschen aus den Kurven, jede Grafik lässt sich einzeln exportieren. Darüber stehen die abgeleiteten Kennzahlen: Final Train Loss, Epochen und Steps, Loss-Reduktion und Overfitting-Gap.
Train- und Validation-Loss in einer Kurve, darunter Ø Loss pro Epoche und der Val-Train-Gap als eigenes Diagramm.
Train- und Validation-Loss in derselben Kurve
Overfitting-Gap als eigene Kennzahl und eigenes Diagramm
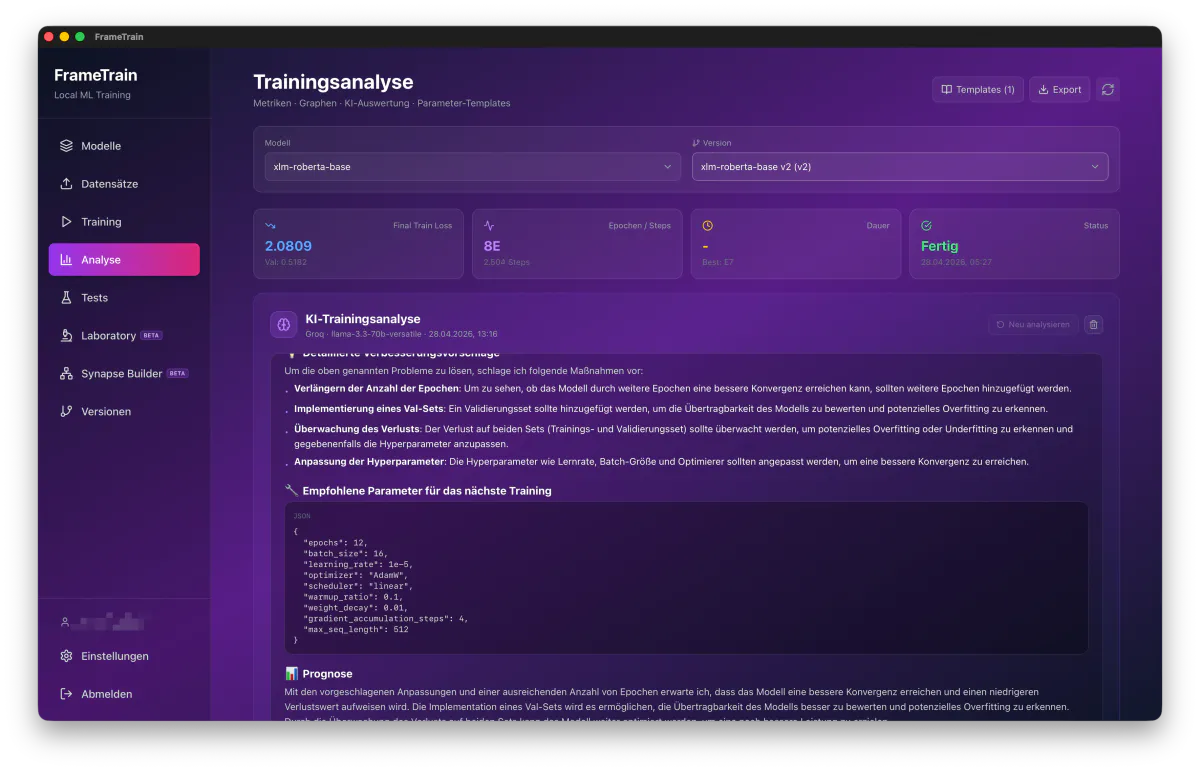
FrameTrain schickt die Metriken eines Laufs an ein Sprachmodell deiner Wahl und bekommt eine Auswertung im Klartext zurück: was schiefgelaufen ist, welche Maßnahmen helfen und mit welchen Parametern der nächste Lauf starten sollte. Der Parametervorschlag kommt als JSON-Block, den du mit einem Klick als Training-Template speicherst.
KI-Trainingsanalyse zu einer konkreten Modellversion: Diagnose, empfohlene Parameter, Prognose.
Auswertung in Fließtext statt roher Zahlenreihen
Parametervorschlag als Training-Template speicherbar
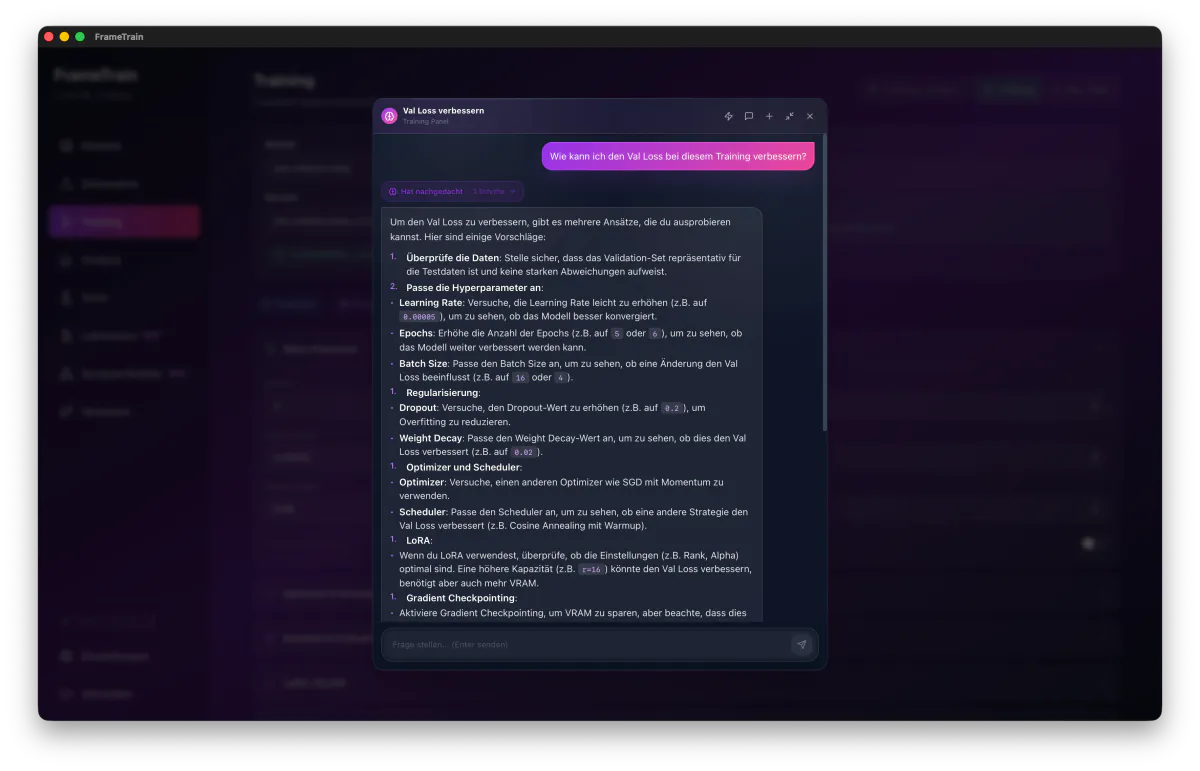
Der KI-Coach ist ein Chat, der weiß, in welchem Panel du gerade stehst. Auf „Wie kann ich den Val Loss bei diesem Training verbessern?“ antwortet er mit Bezug auf die geladenen Werte statt mit Allgemeinplätzen – von der Learning Rate über Dropout und Weight Decay bis zur LoRA-Kapazität. Konkrete Vorschläge übernimmst du per Button direkt unter der Antwort, und ein / im Eingabefeld öffnet vorbereitete Fragen passend zur Seite.
Der Coach sitzt über dem Panel, aus dem er seinen Kontext zieht – hier das Training-Panel.
Kennt bei jeder Nachricht den Zustand der aktuellen Seite
Skills per / – vorbereitete Fragen für jede Seite
Übernehmen-Buttons nur dort, wo sie etwas bewirken
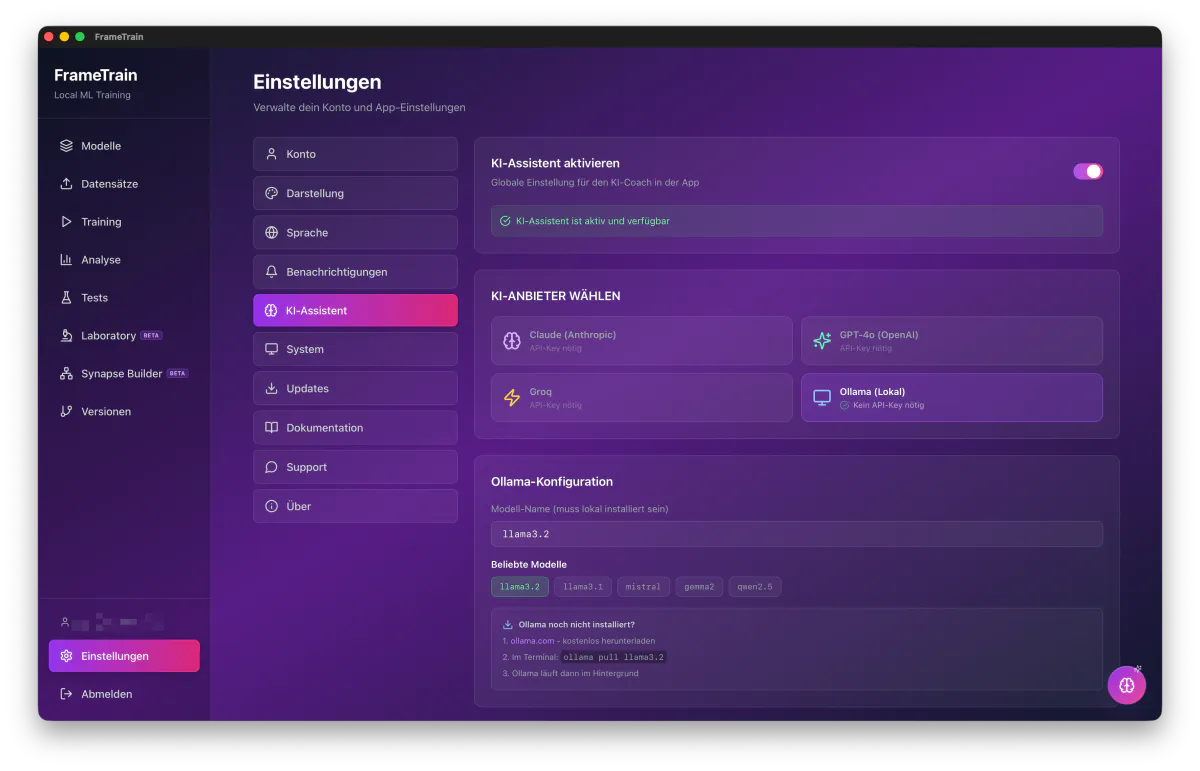
Welches Sprachmodell hinter Coach, Analyse und Assistenten steckt, entscheidest du: Claude, OpenAI und Groq laufen über deinen eigenen API-Key, Ollama komplett lokal und ohne Key. Jeder Anbieter behält seinen Key, ein Wechsel verliert keinen. Das Token-Budget von Minimal bis Unlimited legt fest, wie ausführlich und gründlich alle KI-Funktionen arbeiten. Wer gar keine KI-Funktionen möchte, schaltet den Assistenten global ab. Das Training selbst ist davon unabhängig und läuft in jedem Fall auf deiner Hardware.
Anbieterwahl für die KI-Funktionen. Ollama läuft lokal und braucht keinen API-Key.
Ollama lokal, ohne API-Key und ohne Datenabfluss
Ein Key pro Anbieter, sicher im Schlüsselbund des Systems
Token-Budget in fünf Stufen, KI global abschaltbar
Versionen – jedes Training legt einen neuen Stand an
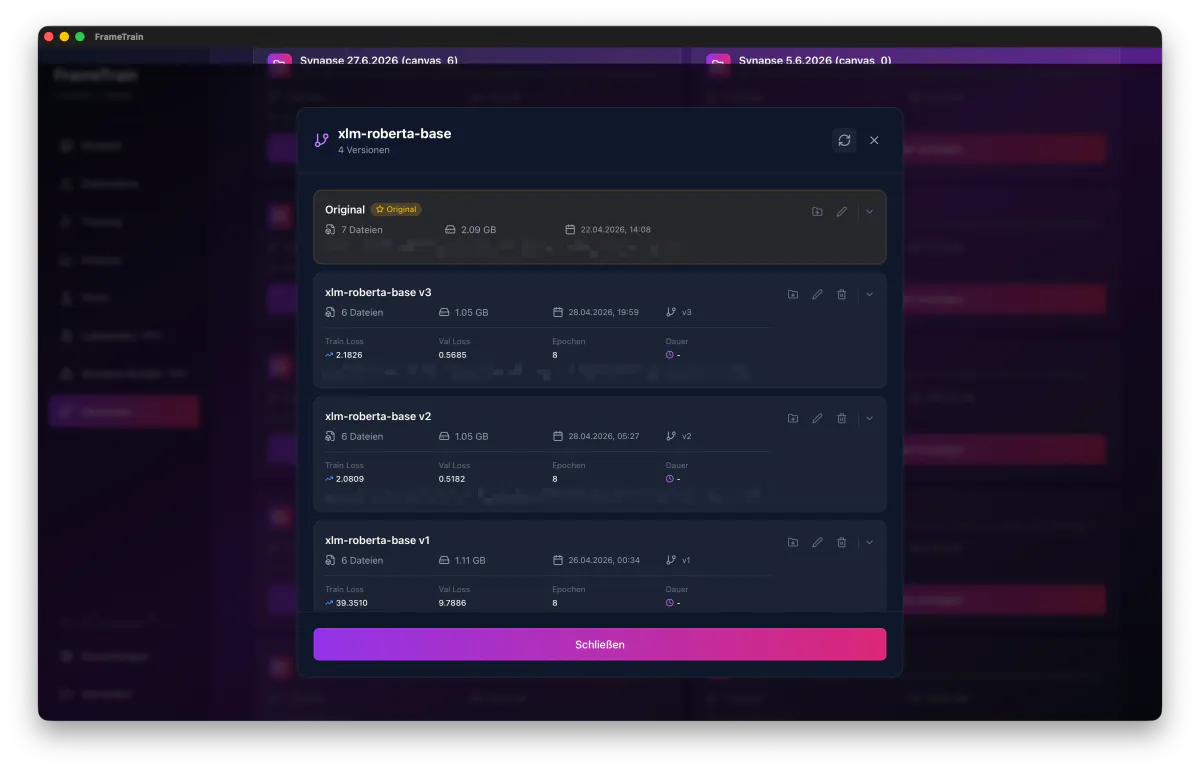
Ein Trainingslauf überschreibt nichts, sondern legt eine neue Version an. Die Versionsliste zeigt pro Stand Train Loss, Val Loss, Epochen, Größe und Ablagepfad; das importierte Original bleibt unangetastet. Ein Rückschritt auf einen früheren Stand heißt: die ältere Version auswählen.
Vier Stände desselben Modells. Am Train- und Val-Loss je Version ist ablesbar, welcher Lauf etwas gebracht hat.
Das importierte Original bleibt immer erhalten
Metriken und Größe je Version
Ablagepfad jeder Version ist sichtbar
13
Labor – trainierte Modelle an echten Samples testen
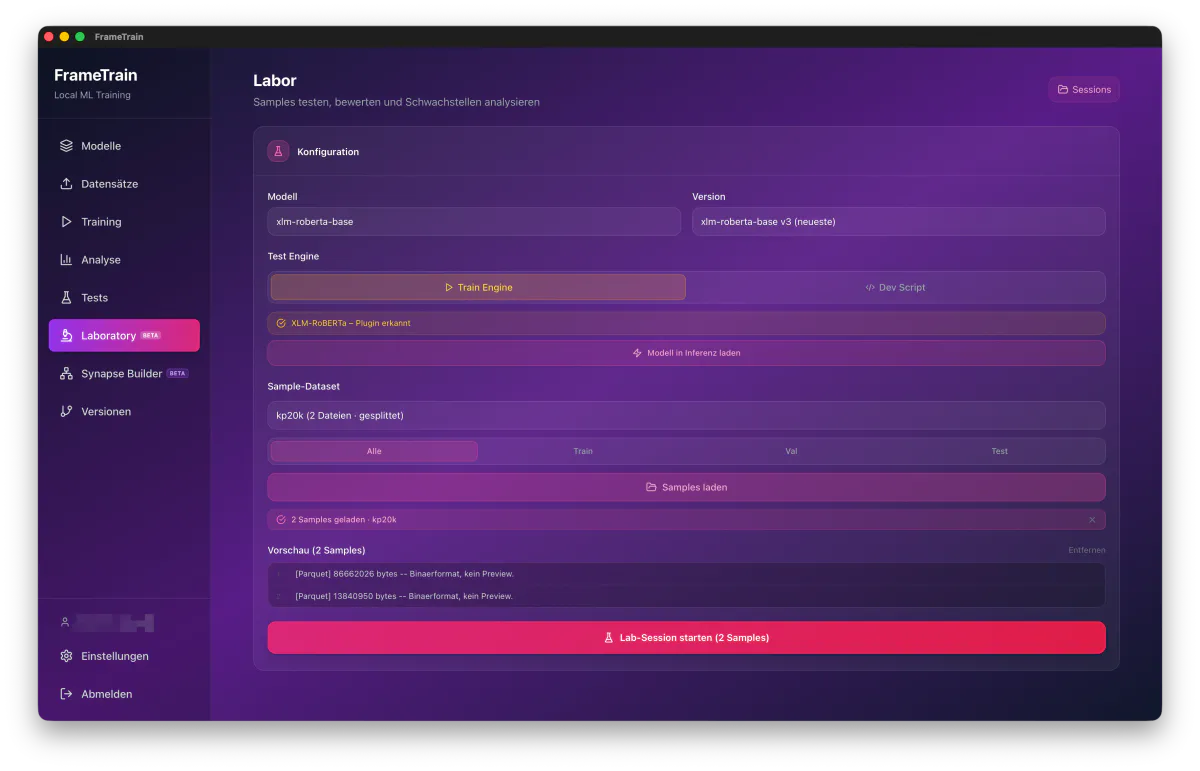
Im Labor lädst du einzelne Samples aus Train, Val oder Test und lässt die trainierte Version darauf antworten: Test Engine oder Dev-Script wählen, Modell in Inferenz laden, Samples laden, Session starten. Für die Frage, ob ein Modell in der Praxis taugt, reicht ein Loss-Wert nun einmal nicht aus.
Labor-Konfiguration: Version, Engine und Sample-Auswahl, bevor die Session startet.
Samples gezielt aus Train, Val oder Test
Train Engine oder eigenes Dev-Script
Sessions bleiben zum Vergleich gespeichert
14Beta
Synapse Builder – Architektur als Graph
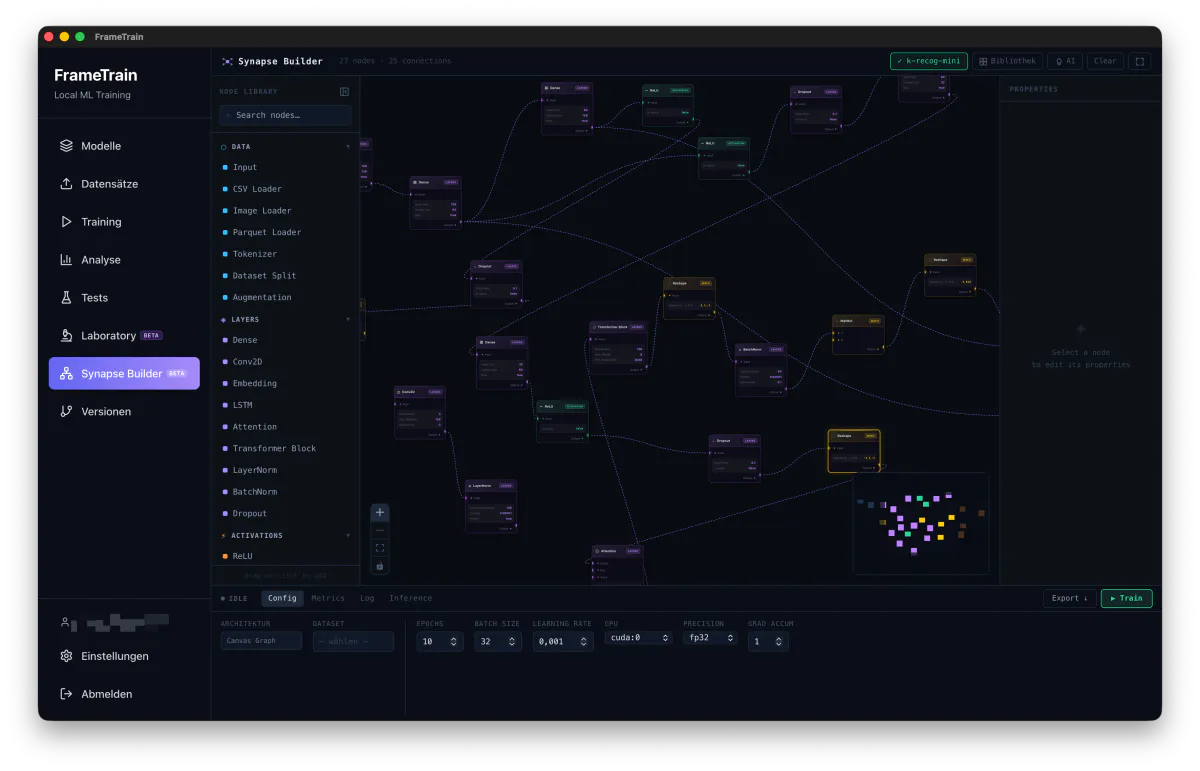
Der Synapse Builder baut Netze aus Knoten: Input, CSV-, Image- und Parquet-Loader, Tokenizer, Dataset Split, Augmentation, dazu Dense, Conv2D, Embedding, LSTM, Attention, Transformer Block, LayerNorm, BatchNorm und Dropout. Unten liegt die Trainingsleiste mit Epochs, Batch Size, Learning Rate, GPU, Precision und Grad Accum – trainiert wird aus demselben Fenster heraus.
Synapse Builder mit 27 Knoten und 25 Verbindungen. Die Trainingsleiste unten startet den Lauf direkt aus dem Canvas.
Knotenbibliothek für Daten, Layer und Aktivierungen
Training direkt aus dem Canvas starten
Architektur exportierbar
Selbst ausprobieren
FrameTrain läuft auf Windows, macOS und Linux und trainiert vollständig auf deiner eigenen Hardware. Keine Cloud, keine Daten, die dein Netzwerk verlassen.